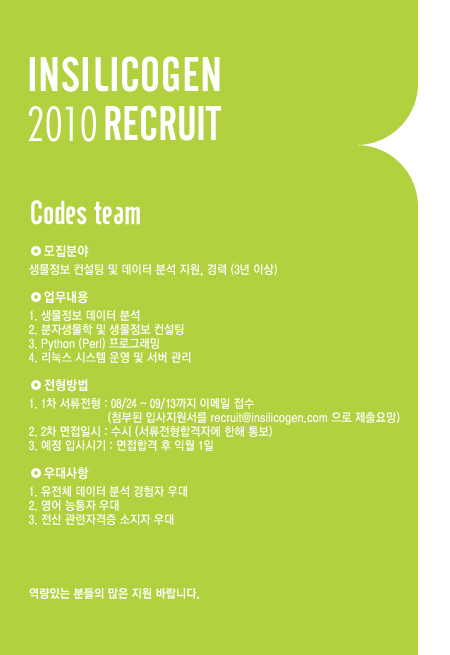
[채용공고] 역량있는 분들의 많은 지원 바랍니다.
- Posted at 2010/08/26 17:55
- Filed under 채용공고
 입사지원서.doc
Posted by 人Co

Posted by 人Co
Posted by 人Co
Posted by 人Co
입력할 데이터의 포맷은 DNA Chip 실험 분석을 통해서 얻어진 정보들을 탭 분리형식으로 구성되어진 파일과 엑셀 형식으로 되어 있는 파일을 불러들일 수 있다. 또한 Affymetrix, Agilent, Illumina 사와 같은 기존에 가장 많이 분석에 이용되고 있는 상용화 DNA Chip 정보 포맷도 쉽게 불러들여 분석을 진행 할 수 있다. 탭 분리형식으로 데이터가 저장된 파일을 불러들여 분석을 할 경우 아래와 같이 모두 10가지 단계를 거치게 된다.
실험 데이터의 형식, 파일 포맷, 그리고 입력할 파일과 최종 저장할 디렉토리를 선택하면 모두 10가지 단계의 입력과정을 거치게 된다. 첫 번째 단계에서 부터 순서대로 실험 데이터의 헤더 설정, 데이터가 시작되는 행의 지정, Probe identity를 표현하는 컬럼 지정, 샘플의 layout 설정, 데이터의 마지막 컬럼 지정, 부가적으로 사용될 annotation으로 컬럼 설정, 샘플 타입, 부가적으로 Probe를 식별하는데 사용하는 Identifier, expression 분석에 사용되는 annotation 컬럼을 선택한다. 마지막 열 번째 단계에서는 반복실험을 수행한 샘플들간의 상호 연관성을 볼 수 있는 sample correlation 단계로 샘플 간에 가까운 상관관계가 있는 것끼리 그룹으로 설정하여 Tree 형태로 보여준다. 여기에서 correlation이 잘못된 경우 분석에서 제외할 샘플을 선별 할 수 있다.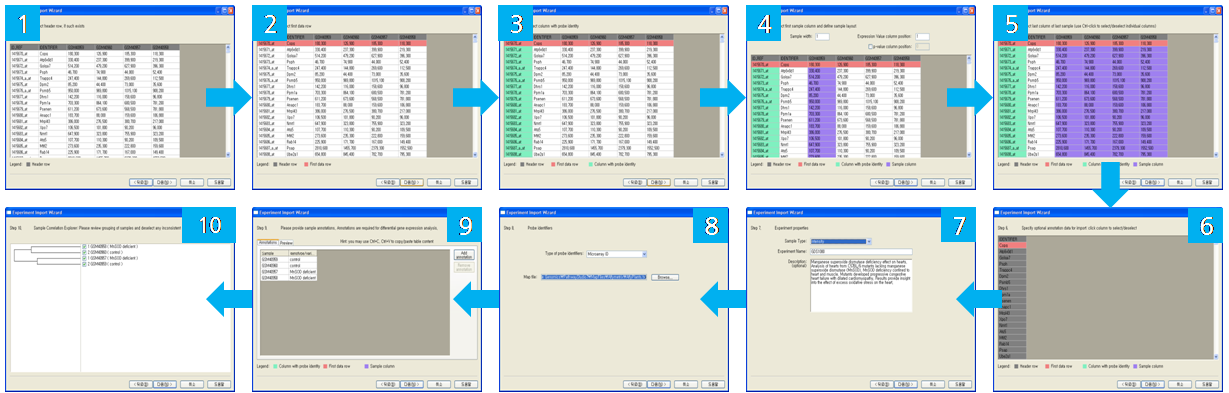
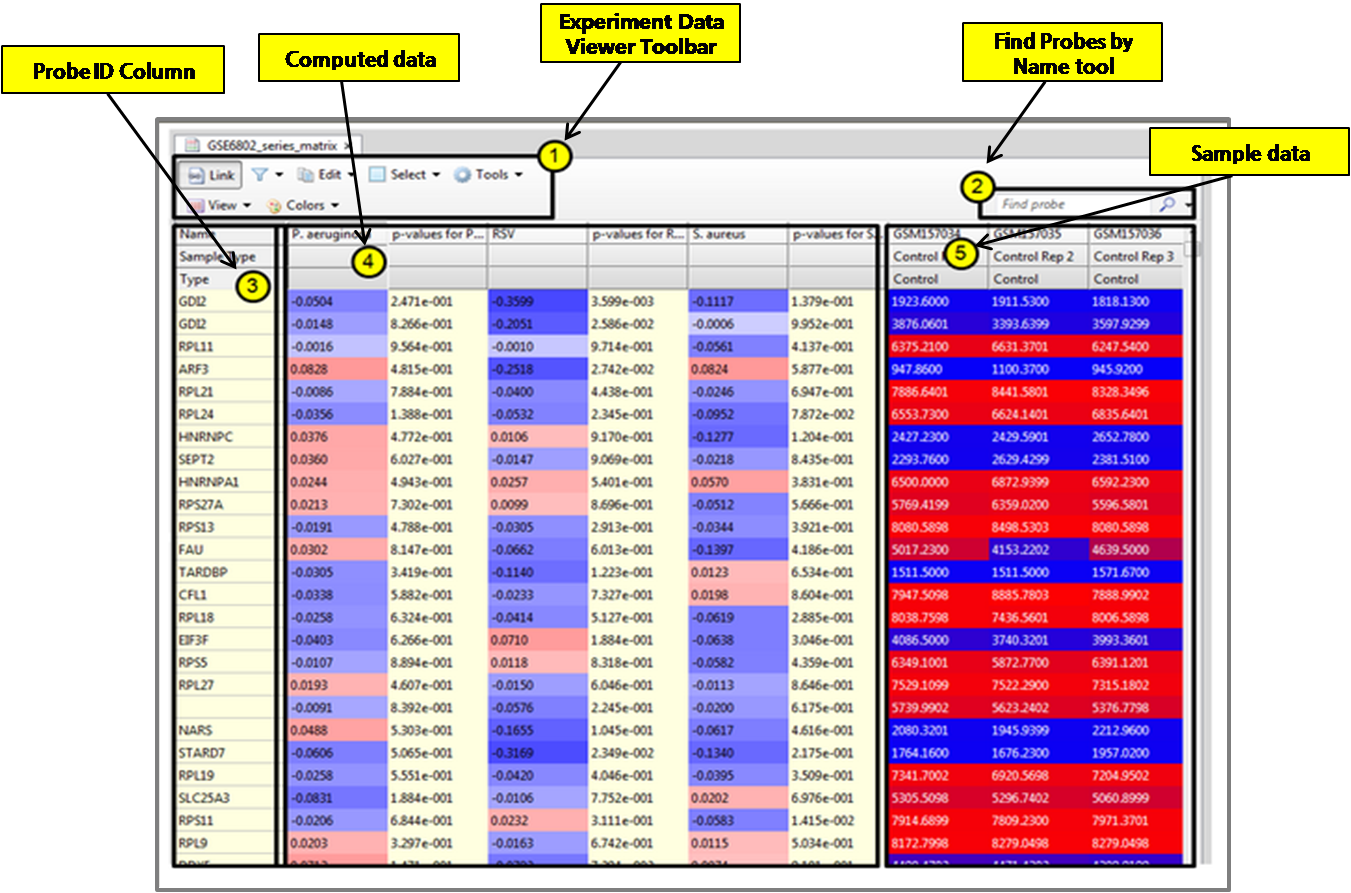
Fisher's Exact Test와 Gene Set Enrichment Analysis는 Enrichment를 분석하는 서로 다른 알고리즘이고 Sub-Network Enrichment는 ResNet에서 사용자가 직접 Gene Set을 설정해 주는 것으로 알려진 Gene Set을 사용하는 앞의 두 알고리즘과는 다르다.
먼저 Fisher's Exact Test를 수행하기 전에 통계적으로 유의한 유전자 리스트를 확인하기 위해 필터링 과정을 거친다. Toolbar에서 Filter Probes by value를 클릭하면 대화창이 나타난다. 필터링을 적용하고자 하는 샘플을 선택하고 Probe 범위와 P-value cutoff 값을 입력하여 필터링을 수행 한다. 이제 Filter를 통해 나온 데이터들을 이용해서 Fisher's Exact Test를 수행한다. 분석하고자 하는 데이터 컬럼에서 마우스 오른쪽을 눌러 Find Pathway/Groups Enriched with Selected Entities를 선택한다. 대화창이 나타나는데 여기에서 실험 데이터를 대상으로 Fisher's Exact Test를 수행 할 Ontology나 Pathway를 선택한다.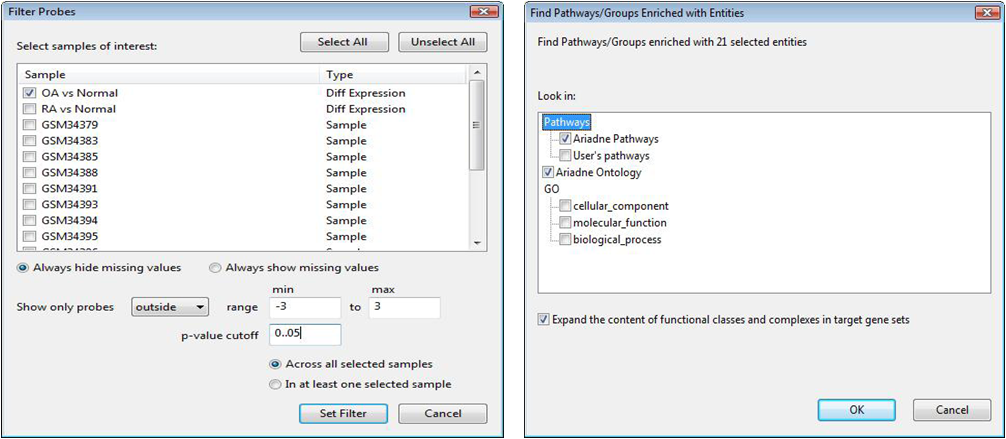
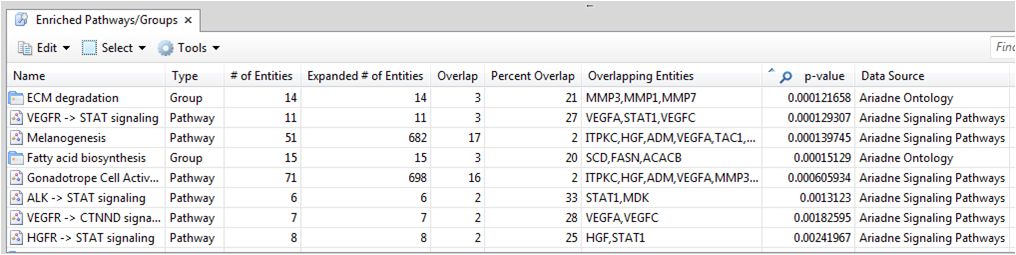
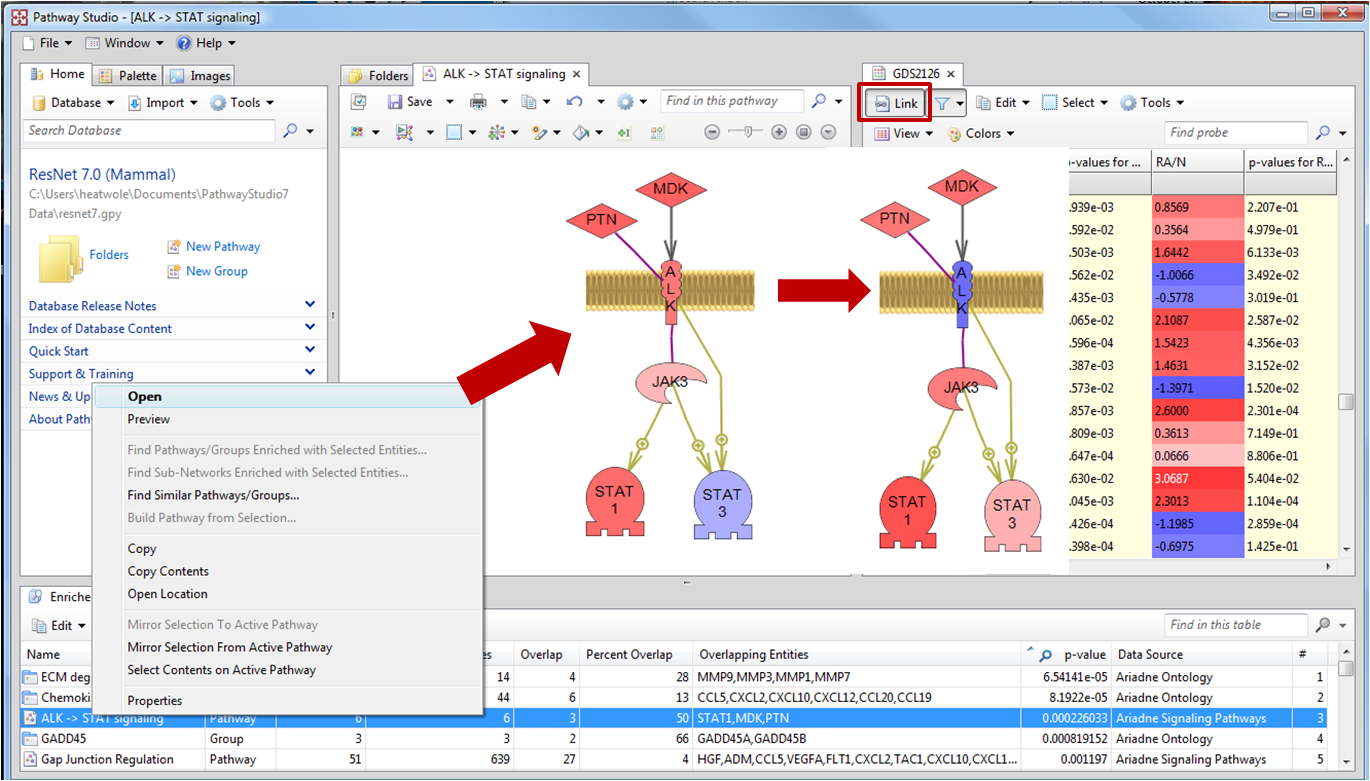
두 번째 알고리즘인 Gene Set enrichment 분석은 Fisher's Exact Test와 비슷한 분석이지만 실험 데이터에 서열화 방법을 적용하였다는 차이점이 있다. Gene Set enrichment 분석을 할 때에는 Filter를 적용하지 않고 분석을 시작한다. Enrichment 분석 할 알고리즘으로 2가지가 제공되는데 Mann-Whitley Utest와 Kolmogorov-Smirnov가 그것이다. 두 가지 모두 순위척도 자료를 위한 비모수 통계방법으로 두 모집단 사이에 유의한 차이가 있는지를 검정할 때 사용한다.
Gene Set enrichment 분석도 마찬가지로 분석이 완료되면 그림 3과 같은 결과 테이블을 제공한다. 결과 테이블에서 Fisher's Exact Test와 다른점이 있다면 Median fold change 값을 제공한다는 것이다. 이 값을 통해 측정된 Entity 그룹에 대한 fold change 값의 분포를 알 수 있고, 결과 set에서 더 up regulated 되거나 더 down regulated 되는 그룹을 빠르게 확인 할 수 있도록 정보를 제공해 주고 있다.
이렇게 분석 결과 나온 pathway는 여러 가지 pathway를 합쳐서 보거나, 공통된 것 또는 공통된 것을 제외한 나머지 부분만을 볼 수도 있다. 또한 실험데이터가 Time-course로 진행된 실험이라면 특정 Entity가 시간에 따라 어떻게 발현이 달라지는지 볼 수 있다. 보고자 하는 Entity를 하나 선택하고 마우스 오른쪽을 클릭하면 Show diagram이 있다. 이것을 클릭하면 그림에서 보는 것과 같이 Line plot 형태로 그려진 diagram이 생성된다. 다시 이 다이어그램을 클릭하고 마우스 오른쪽을 노르면 Show as Heat Map 메뉴가 있는데 이것은 Line plot 형태의 다이어그램을 Heat Map 형태로 바꾸어 볼 수 있는 역할을 한다.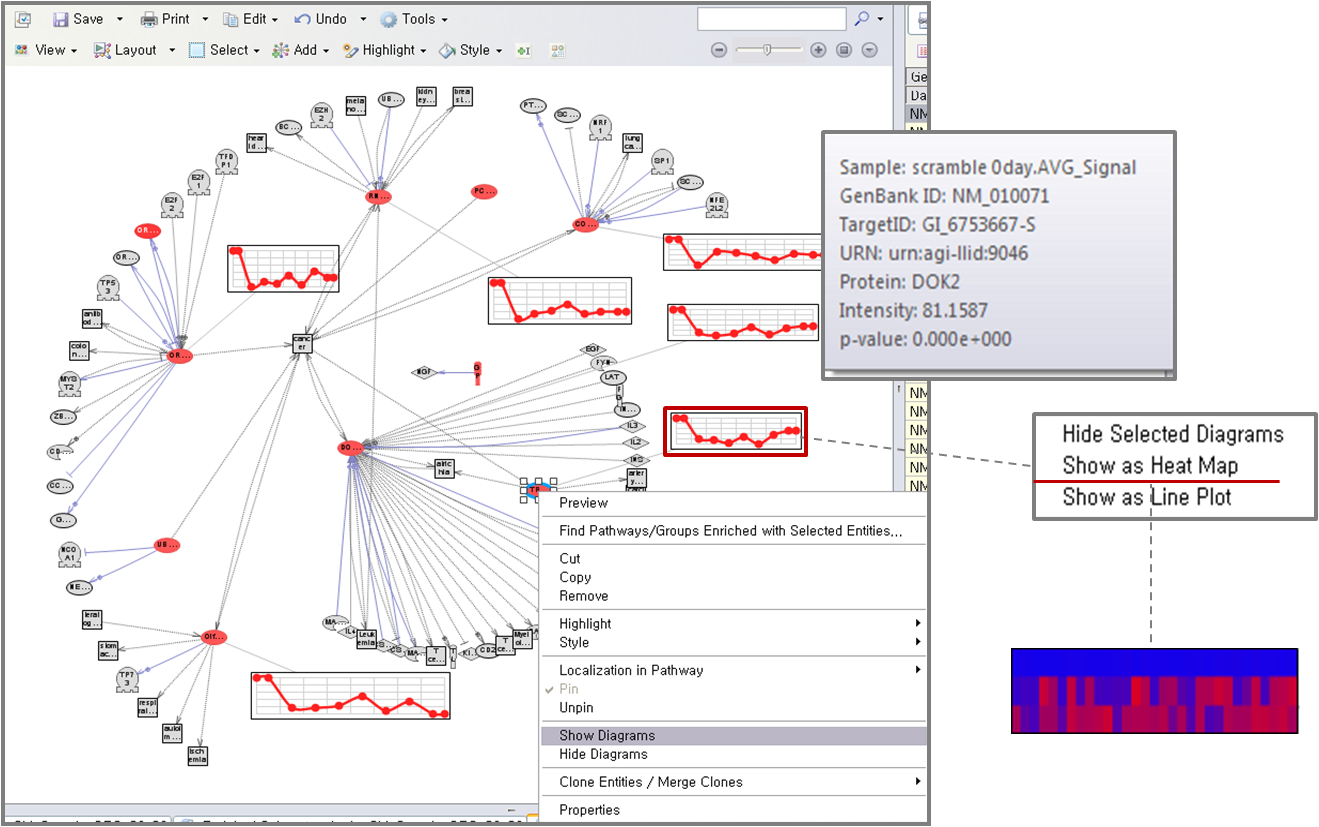
Posted by 人Co

Posted by 人Co
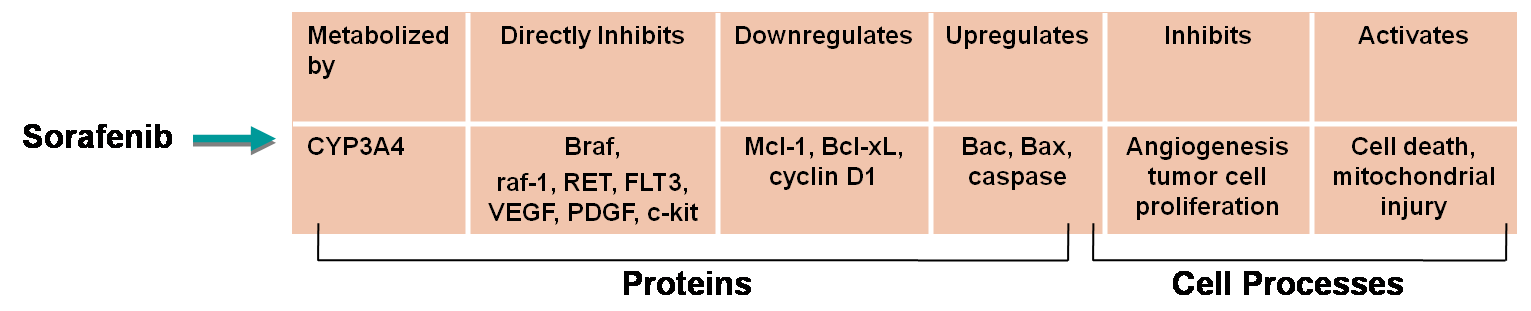
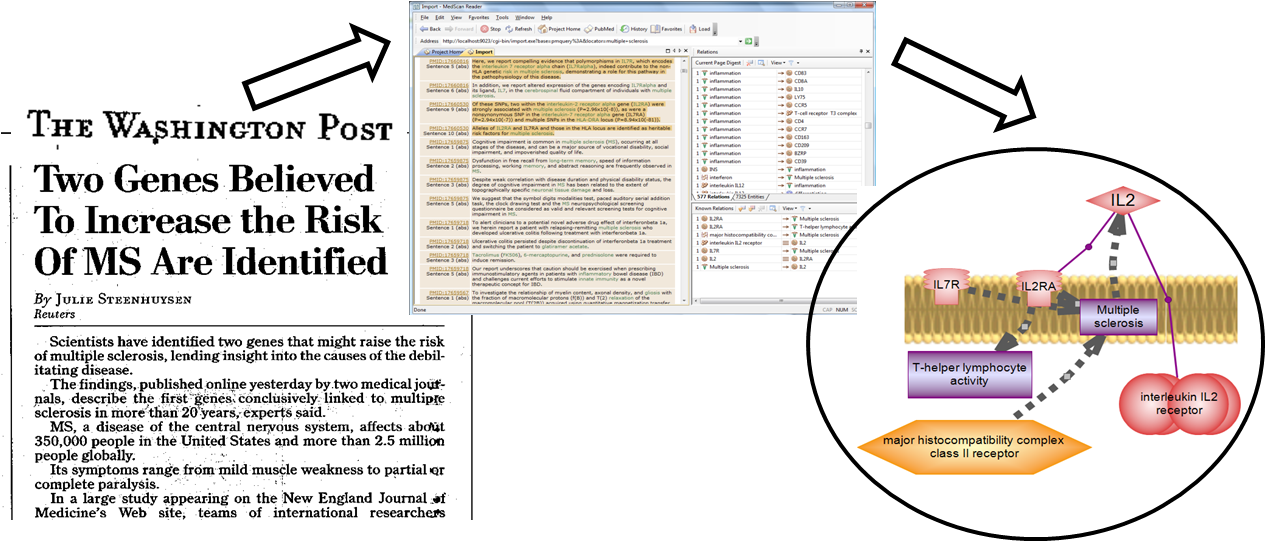
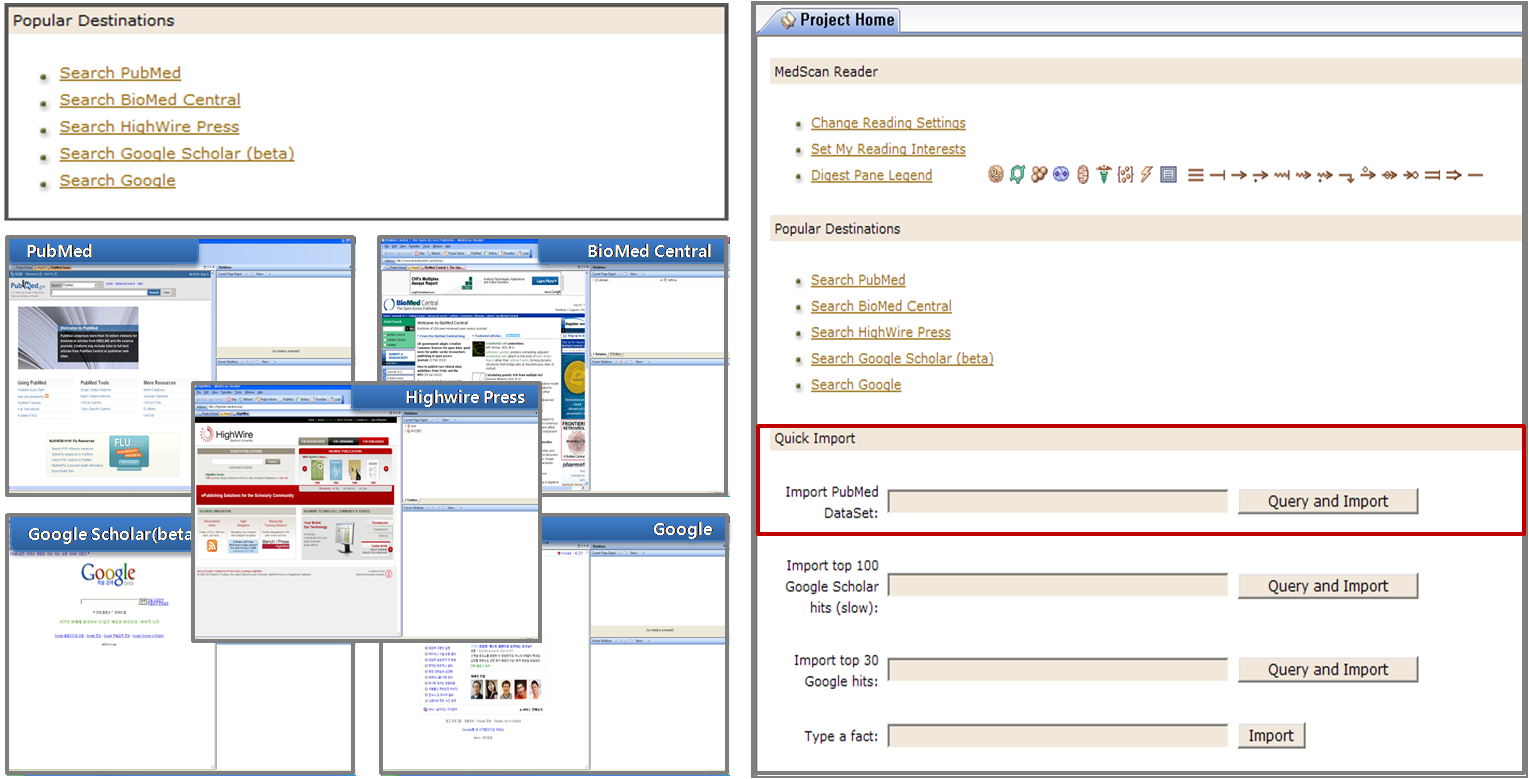
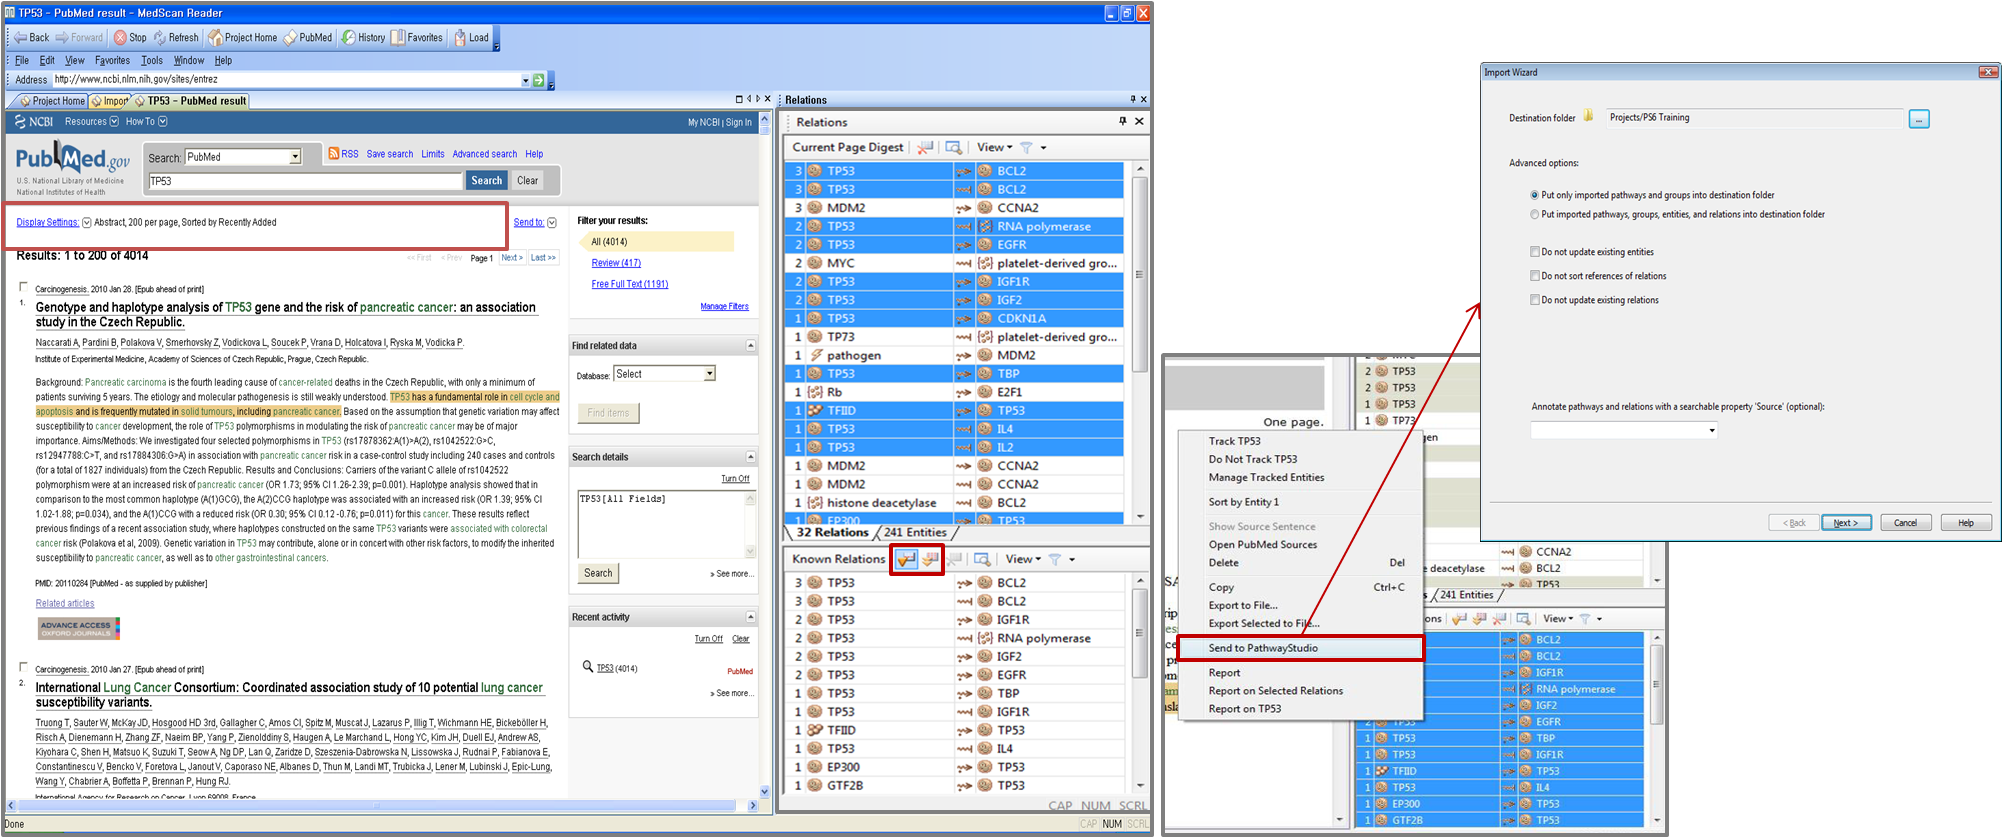
미국에는 해마다 전립선암 환자가 증가하고 있는데 반해 인도인들은 전립선암 환자가 거의 발생하지 않고 있다. 유전적인 요인도 있겠지만, 식습관의 차이가 전립선 암환자의 발생을 유도하거나 억제하지 않을까라는 단순한 궁금증을 가지고 카레와 전립선암과의 연관관계에 대한 연구를 시작하고자 한다. 이때 우리는 “인도인들이 즐겨먹는 카레의 주성분에서 전립선암을 억제하는 상호기작이 있을 것이다”라고 가정할 수 있다. 그럼 카레의 주성분은 무엇일까? 카레의 색깔이 노란색인 것은 커큐민이라는 성분때문인데, 이 커큐민이 카레의 주성분이다. 전립선암과 우리가 즐겨 먹는 카레의 주성분인 커큐민은 상호 어떤 관계가 있을까? 실험을 통해서 일일이 검증을 해야 확인할 수 있겠지만, PubMed와 같이 과학 문헌 데이터베이스에서 커큐민 성분에 영향을 미치는 유전자에 관련된 논문과 전립선암에 관여하는 유전자에 대한 논문을 찾은 후 ‘커큐민-유전자-전립선암’과의 관계를 유추할 수 있다.
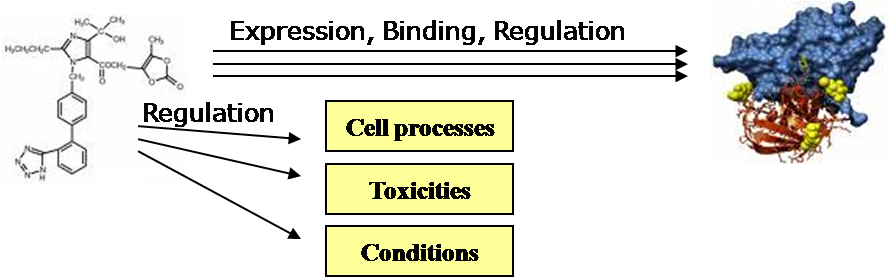
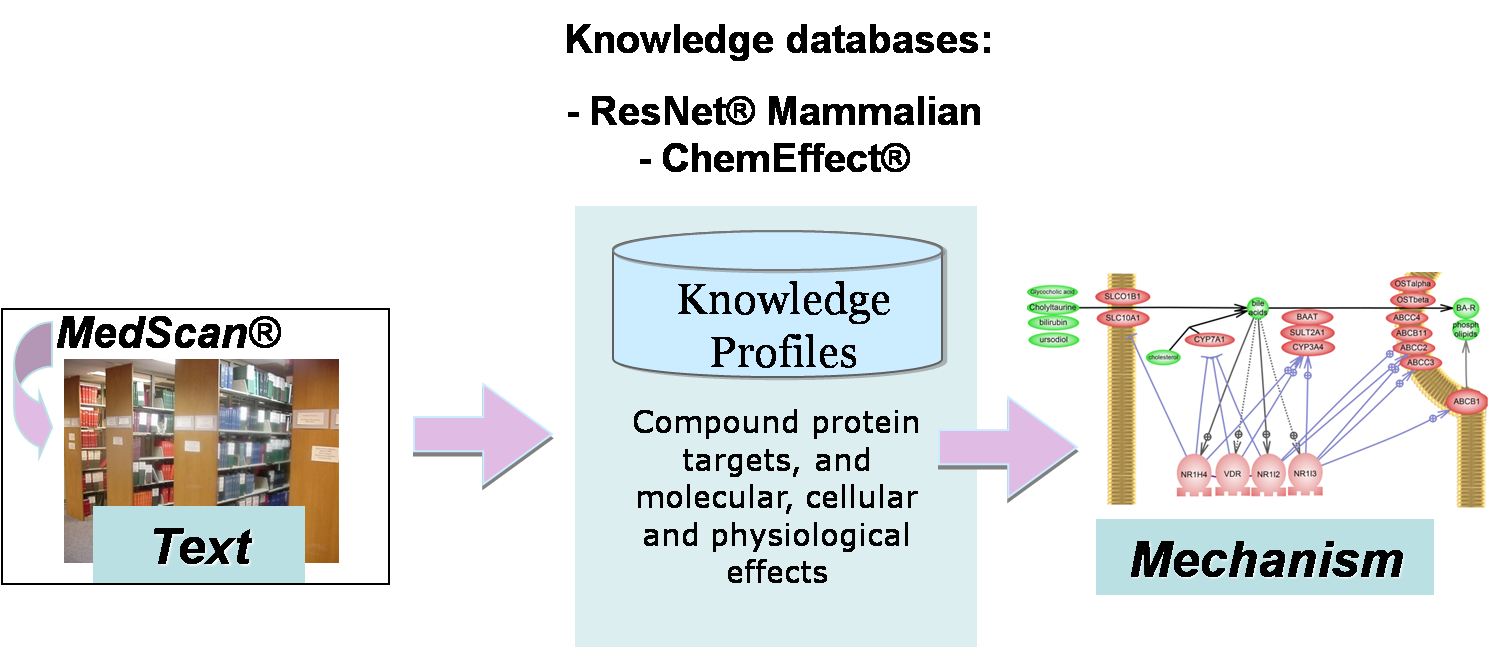
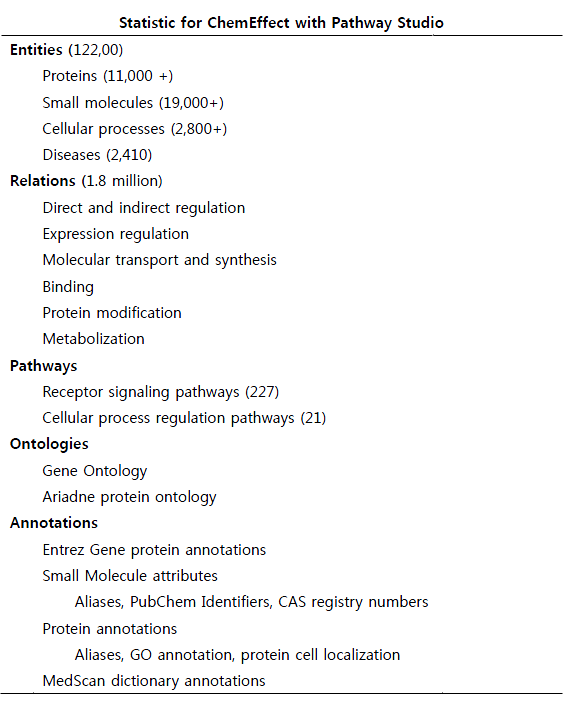
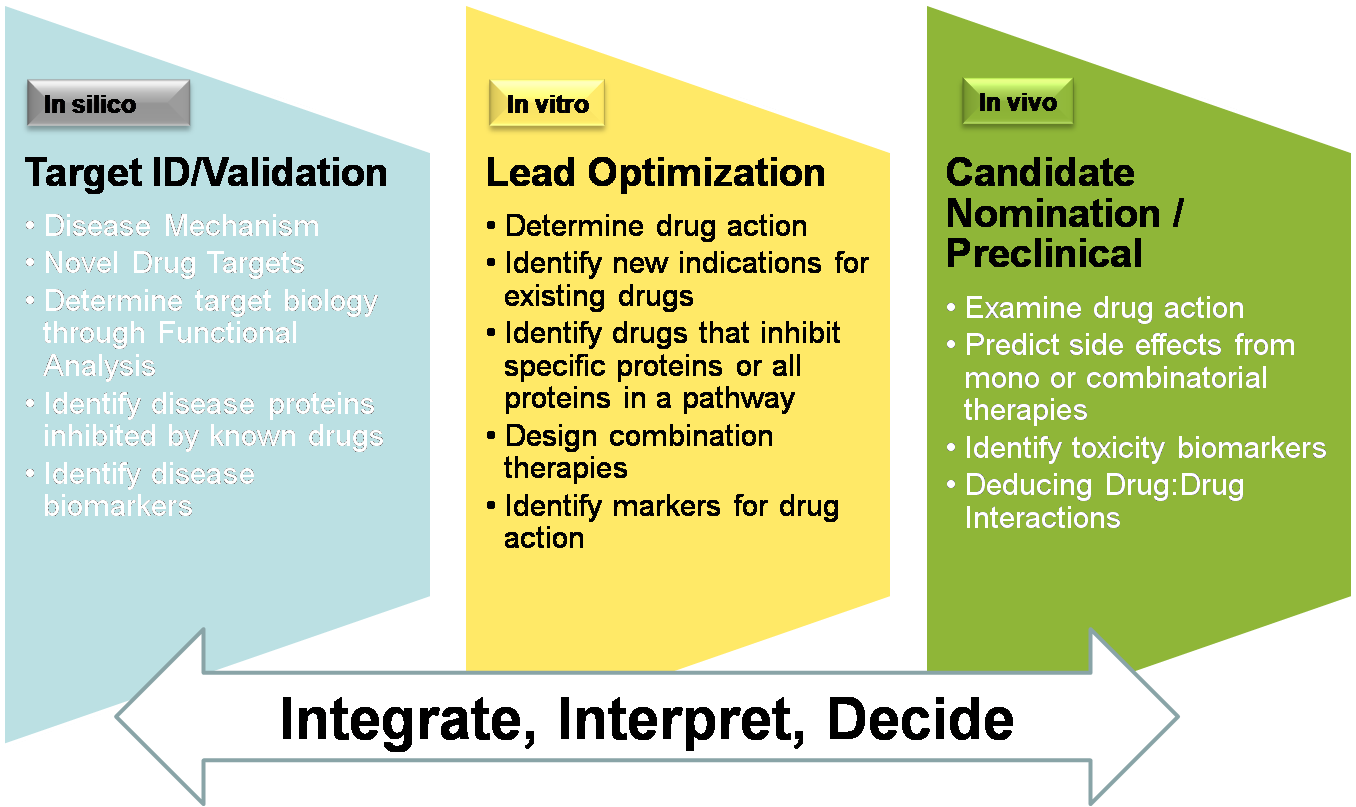
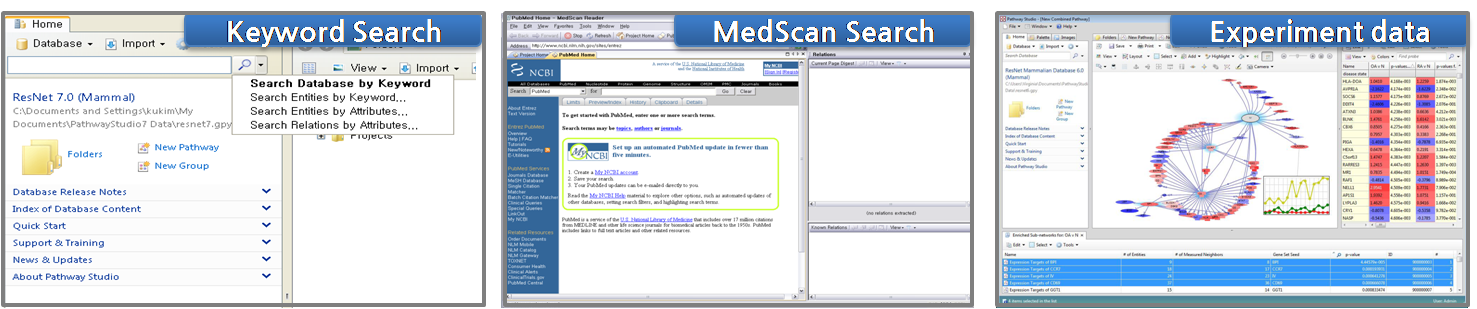
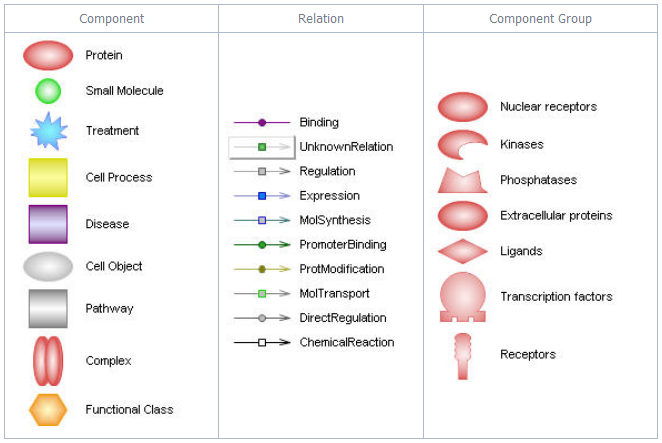
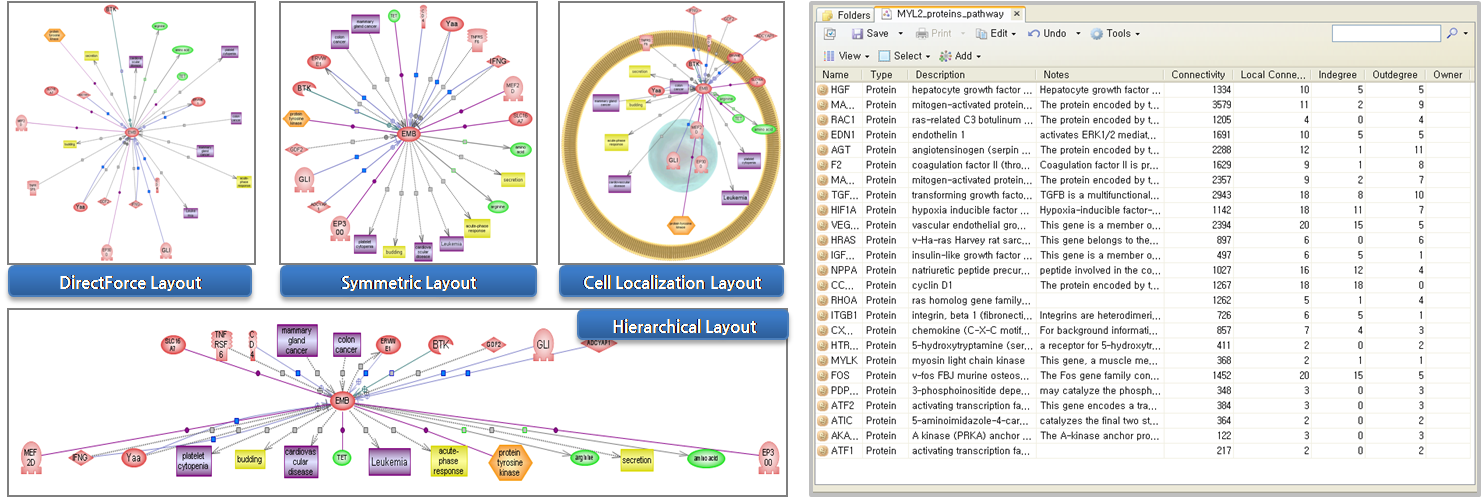
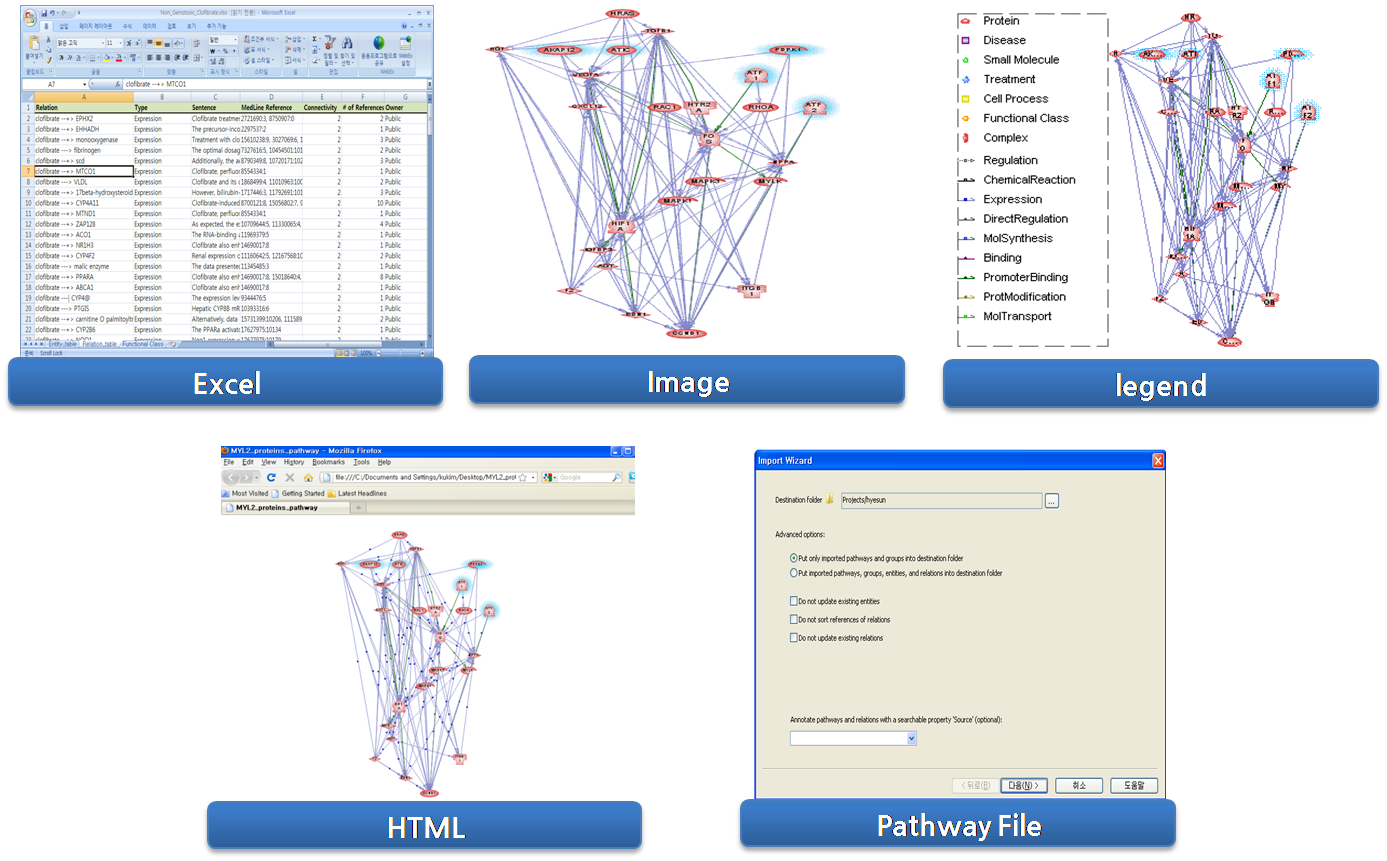
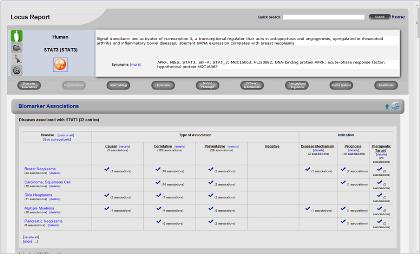
이와 같이 신약을 발굴하기 위해서 바이오마커를 찾거나, 특정 질병에 관여하는 유전자들이 무엇인지 알고자 할 경우, 또는 DNA Chip 분석을 통해서 얻어지는 차등 발현 유전자들이 공통적으로 관여하는 질병을 찾거나, 유전자들의 상호 연관관계를 알고자 할 경우에 사용되는 유용한 프로그램 가운데 PathwayStudio라 는 프로그램을 소개하고자 한다.
Posted by 人Co
HGMD는 현재 유전체 서열상의 변이로 인한 질병의 병변 및 유전자의 이름 그리고 유전체상의 위치 정보를 문헌정보에 근거하여 서비스하고 있다. 이러한 정보는 OMIM, Entrez Gene 그리고 Human Gene Nomenclature Committee를 포함한 대표 web-base 데이터들과 링크를 통해 변이에 의한 표현형, 구조적 정보들이 함께 제공되고 있다. 그 자세한 내용은 아래와 같다.
Up-to-date Mutation Data
HGMD Professional은 위와 같이 변이 정보에 대한 서열 정보, SNP정보, HGVS nomenclature 정보를 링크를 통해 서비스하고 있으며 이들의 조절 메카니즘과 관련된 transcription factor 정보도 함께 지원하고 있다. 더욱이 이러한 모든 정보의 근간이 되는 문헌정보를 함께 제공하고 있어 그 신뢰성이 매우 높다 하겠다.
Expanded Search Engine : 최신의 데이터를 사용자 편의에 의한 주제 중심의 인터페이스로 제공하고 있다. 키워드 방식을 이용한 특정 유전자, 질병의 상태, 변이정보, 문헌정보를 통한 검색이 가능하며 알파벳 인덱싱을 통한 검색도 가능하다.
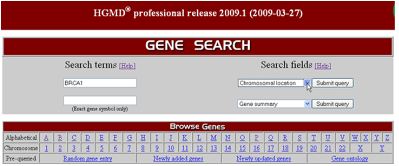
또한 특정 chromosome 내에 존재 하는 모든 변이정보를
한 번에 확인 할 수 도 있으며 이들 정보는 모두 다운 로드 기능을 통해 local PC에 저장이 가능하여
필요할 때 언제든지 활용이 가능 하다(Figure 2).
키워드 검색을 통한 유전자 검색의 경우 Figure 3에서 보여 지는 것과 같이 관련 유전자에서 동반 되는 모든 변이 정보를 확인할 수 있다. Splicing에 의한 변이정보, small deletion, small insertion 그리고 SNP에 의한 정보도 함께 검색 할 수 있다. 또한 transcription factor 정보도 링크되어 다양한 원인에 의해 유발되는 유전적 질환의 생화학적 정보를 통합적으로 확인 할 수 있다.
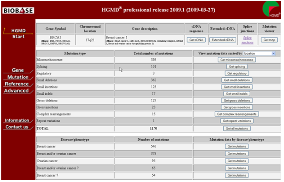
Figure 3. 유전자 검색. 유전자 검색을 통한 다양한 변이 정보 및 질병의 병변, 유전체상의 위치정보, 유전자 발현 조절 정보를 확인 할 수 있다.
Biochemical information : Human의 변이 정보는 구분된 카테고리 정보에서 keyword로 검색이 가능하며 이들의 정보는 이후 모두 다운로드가 가능하다. 질병의 phenotype을 비롯한 유전체 상의 위치 정보, dbSNP와 같은 기존 참조 데이터베이스의 정보, motif, regulation, 참조 문헌 정보까지 한 번에 확인할 수 있다.
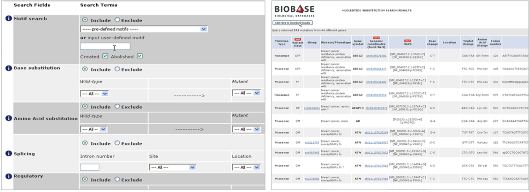
Figure 4. 변이 정보 검색 결과. 유전적 변이에 의한 DNA서열의 변화, 단백질 서열 변이, 참조 데이터베이스, phenotype, gene ontology, 참조 문헌 정보를 모두 다운 받을 수 있다.
Personal genomics 시대에 가장 필수적인 데이터베이스중 하나인 Biobase HGMD는 개인의 잠재적인 유전적 질환의 탐색부터 현재 발병중인 질환에 대한 치료 연구를 위해 많은 기초 데이터를 제공할 것으로 여겨진다. 많은 논문과 데이터베이스를 집대성하여 유전적 질환의 통합적 정보를 제공하고 있는 HGMD는 앞으로 더 많은 연구자들에게 도움이 될 것이다.

Posted by 人Co
Posted by 人Co

Posted by 人Co

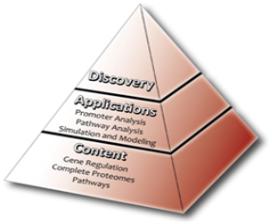
다음 주부터 앞으로 3주 동안, 오늘 간략하게 말씀드린 Biobase 제품군의 세 가지 데이터베이스에 대하여 한 주에 하나씩 좀 더 자세한 내용으로 소개해드릴 예정입니다.
여러분들의 많은 관심 부탁드립니다.
감사합니다.
Posted by 人Co